用 Gatus 检查网站与接口:Docker 部署、成功条件和可解释的故障记录
部署 Gatus 与 SQLite,用状态码和响应内容定义成功,保留检查历史,验证通知和独立恢复。
文章目录
网站返回 200,有时只是代理送出了一张错误页;接口能连接,也可能已经不再返回预期数据。Gatus 可以按配置定时请求目标,并用状态码、响应内容和时间等条件判断结果,适合把几个重要服务的检查放在一个清楚的页面里。
开始时只添加自己管理、允许检查的目标。每项检查都写明它要证明什么:域名能否访问,接口是否返回预期状态,还是某个依赖可以连接。条件越接近实际用途,页面上的绿色状态才越有意义。
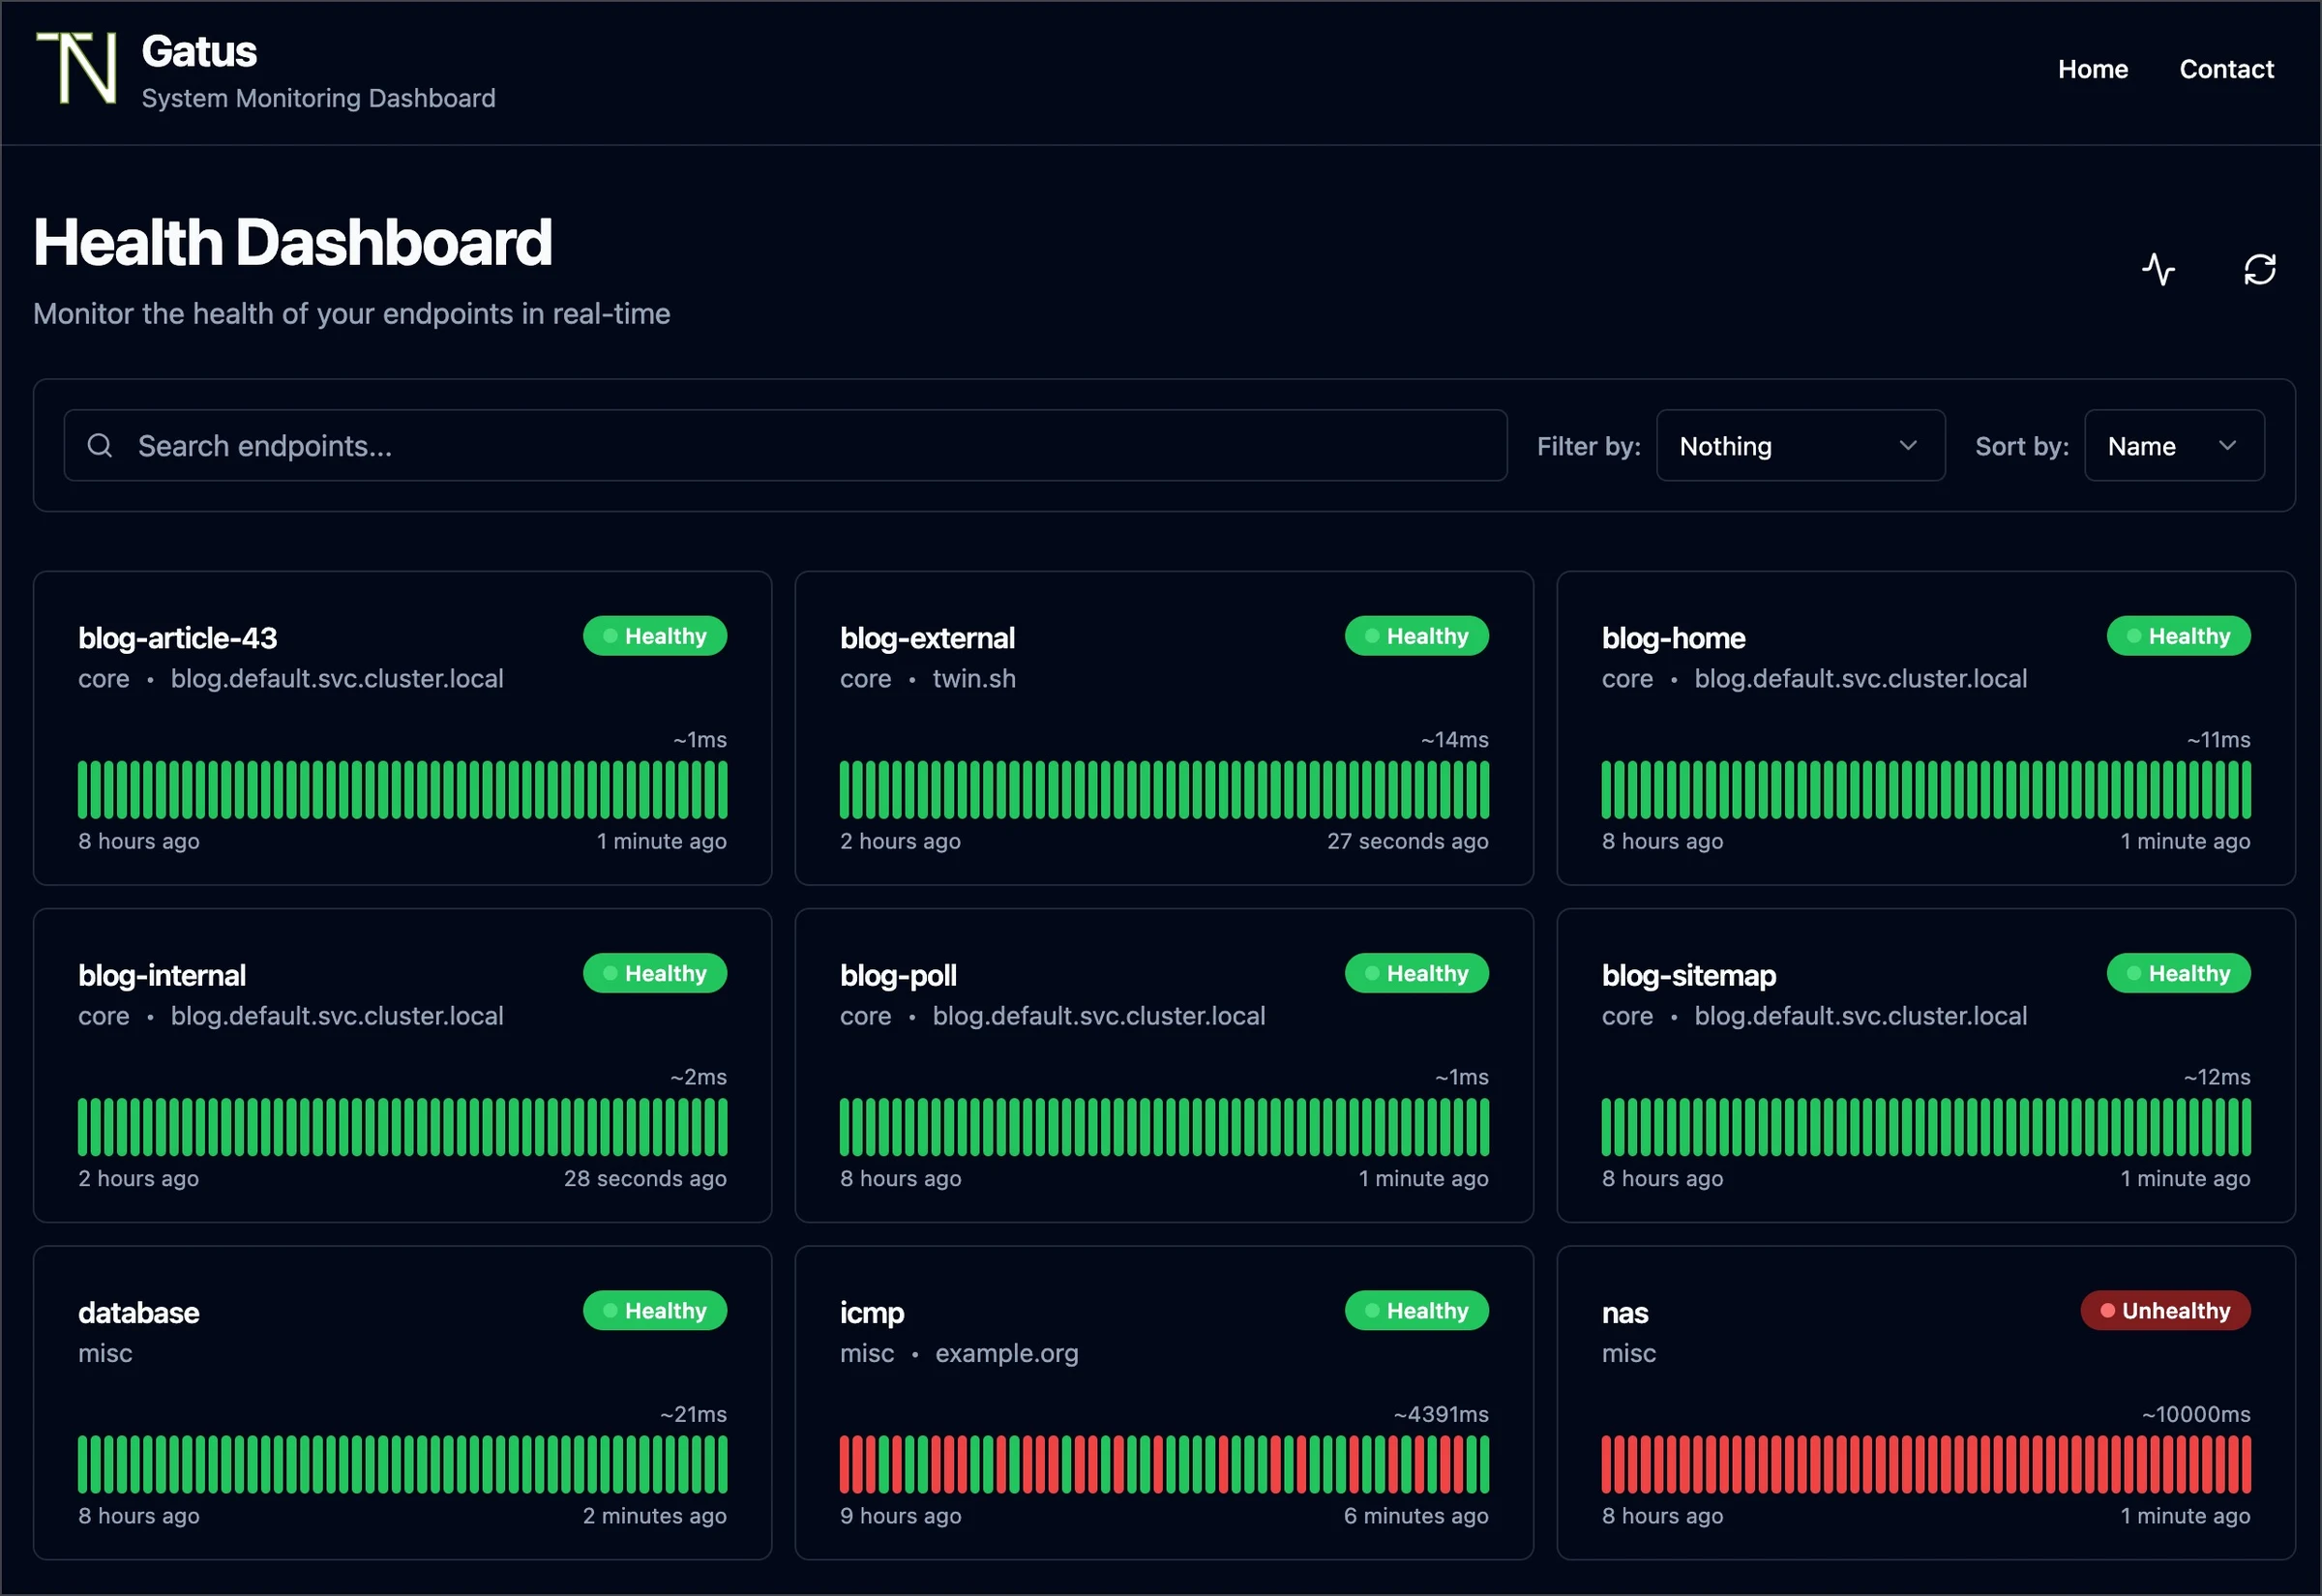
官方示例展示检查结果与历史,数值属于演示环境。图中的数值仅用于展示界面。
部署前先确认 VPS 的磁盘、内存和公网访问条件,也可以查看雨云云服务器;注册时填写优惠码 KuZhuJi。
配置文件与历史数据分开挂载
Gatus 默认使用内存存储,重启以后不能保留相同历史。本例选择 SQLite,把数据库路径放到持久数据目录。配置文件只读挂载,修改规则和写入结果使用不同路径。
mkdir -p ~/services/gatus/config ~/services/gatus/data
cd ~/services/gatus
先保存 config/config.yaml:
storage:
  type: sqlite
  path: /data/gatus.db
endpoints:
  - name: public-homepage
    group: website
    url: "https://example.com/"
    interval: 5m
    conditions:
      - "[STATUS] == 200"
      - "[BODY] == pat(*Example Domain*)"
example.com 是用来验证配置的示例目标,正式检查前换成自己的地址及稳定内容。不能改了 URL 却留下 Example Domain 条件,再把失败理解为网站宕机。内容匹配选择页面确实应当存在的部分,不选每次都会变化的时间。
保存 compose.yaml:
services:
  gatus:
    image: twinproduction/gatus:latest
    ports:
      - "127.0.0.1:8093:8080"
    volumes:
      - ./config/config.yaml:/config/config.yaml:ro
      - ./data:/data
    restart: unless-stopped
docker compose config --quiet
docker compose up -d
docker compose logs --tail=100 gatus
ssh -L 18093:127.0.0.1:8093 user@your-server
本机打开 http://127.0.0.1:18093,等待一轮实际检查,再核对目标、条件及结果。Compose 语法正确只能证明部署描述可解析,应用的检查规则还要由 Gatus 加载并执行。长期使用记录镜像版本或摘要,升级前保存配置与数据。
200 后面还需要一个业务条件
首页检查可以匹配稳定文字,健康接口可以检查 JSON 中的状态。依据实际接口约定设置,不把“任何响应都成功”当作方便的默认规则。接口返回的字段如果改名,检查也需要随它更新。
条件过宽,会把错误页当成正常;条件过窄,页面改个标题就会触发故障。选条件时先看几个正常响应,再看一次可控的失败响应,确认两者能被区分。生产站点不要为了制造失败而停止数据库,使用测试目标验证规则即可。
重定向、认证与缓存也会影响结果。一个登录跳转可能最后返回 200,证明的只是登录页可打开。需要验证已登录业务时,另外设计受控的检查接口和凭据,而不是把个人登录令牌随手写进公开配置。
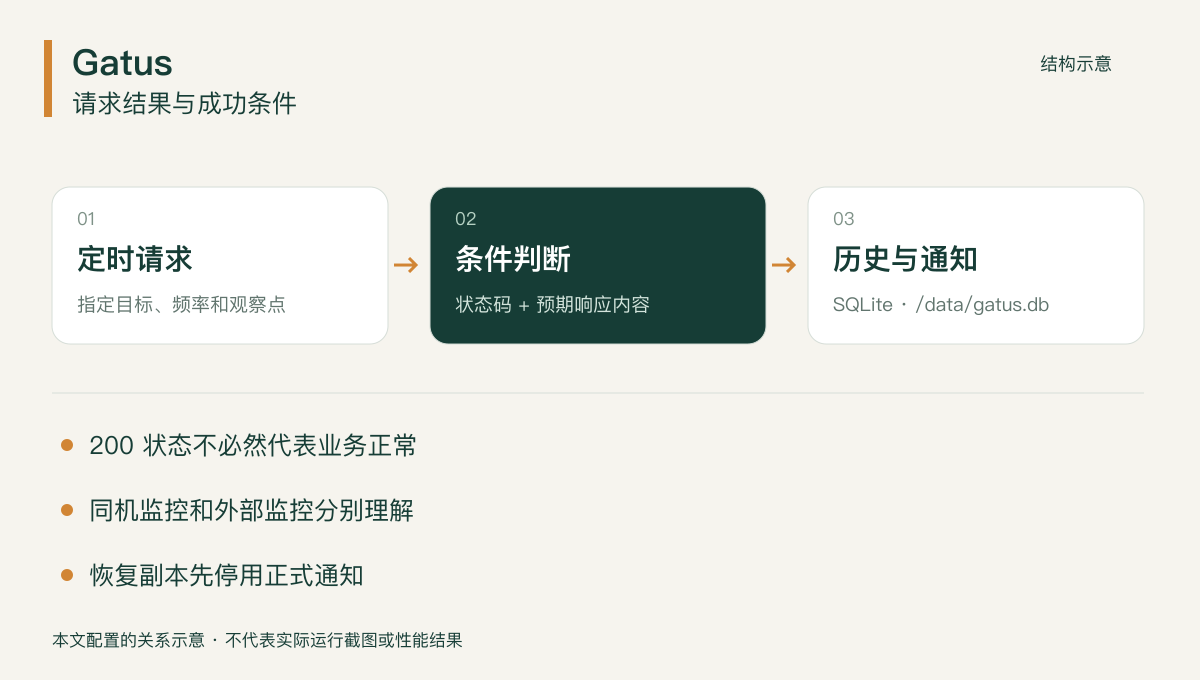
每次结果都来自某个观察点和一组条件。它不能自动代表所有地区、所有登录用户和所有业务路径都正常。
准备独立实例时,可在雨云选择适合的云服务器配置,优惠码 KuZhuJi。配置按实际任务选择,数据库和附件另做备份。
同机观察和外部观察回答不同问题
Gatus 放在被检查服务器上,方便访问内部服务,却也和它共享供电、网络和主机故障。整台机器离线时,监控页面与检查任务可能同时停止,无法从自身继续报告状态。
重要外部入口可以增加另一位置的观察。外部访问失败、内部仍可连接,往往需要继续检查 DNS、证书、代理或网络路径。反过来,外部首页正常,也不能说明内部任务或数据库写入都正常。
增加多个观察点后,保留位置和条件,不把不同请求简单并成一份可用率。一次解析错误、一段网络超时与服务返回错误,是不同现象,处理时先看实际响应和日志。
检查频率按用途设置
本例五分钟一次,适合开始观察少量普通页面。对于长请求、限流接口或成本较高的目标,频率应更低,超时也按实际服务安排。每分钟访问大量页面可能产生不必要的流量和日志。
响应时间来自该次检查路径,不等于完整浏览器页面加载时间。下载 CSS、图片、执行 JavaScript 和用户点击都可能不在同一测量里。展示延迟时写清它是什么请求,别把健康接口耗时称为整个网站速度。
偶发失败可以保留,再根据持续次数和恢复情况选择告警规则。并不是失败记录越少越好;删除短暂故障会让后面的统计失去原本含义。配置调整的时间也记录下来,避免新旧条件的数据被误作连续趋势。
需要增加服务器时,可以打开雨云选购页面,填写优惠码 KuZhuJi;迁移前保留数据与原有部署配置。
通知渠道先独立验收
开始阶段先观察页面,再添加自己确实使用的通知渠道。凭据通过受保护的配置管理,不提交到公开仓库。先发渠道测试,再用测试目标触发一次失败与恢复,确认通知能送到实际接收端。
只验证失败提醒还不够。恢复消息、重复提醒间隔和维护期间的处理方式,都关系到通知是否有用。阈值过敏会让短暂波动反复打断人,最终没人再看;把规则改得过宽,又可能延误处理。
状态页若需要公开,单独检查目标名称、内部 URL、响应内容和事件详情中是否有不适合公开的信息。私人排查页与公开状态页可以采用不同配置,不为了分享一张状态图暴露全部内部服务。
SQLite 与检查配置一起恢复
暂停应用后保存配置和历史数据库:
mkdir -p backups
docker compose stop gatus
tar -czf "backups/gatus-$(date +%F-%H%M%S).tar.gz" config data compose.yaml
docker compose start gatus
外部副本需要保护其中的通知凭据。恢复副本使用独立目录和原版本,先停用正式通知,核对历史可读,再让一个测试目标完成新检查。测试实例不与正式实例共享 SQLite 文件,也不让两套实例重复发送正式告警。