用 Readeck 保存稍后阅读资料:Docker 部署、正文抽取和完整恢复
部署 Readeck 阅读资料库,核对正文抽取、图片代码、浏览器入口与完整目录恢复。
文章目录
看到一篇值得读的文章,先扔进浏览器书签,过几周再找时只剩一个标题;页面改版、图片失效,或者正文夹在一堆导航中。Readeck 适合把有权保存的公开阅读资料集中整理,提取可读内容,再用标签、标注和阅读入口找回来。
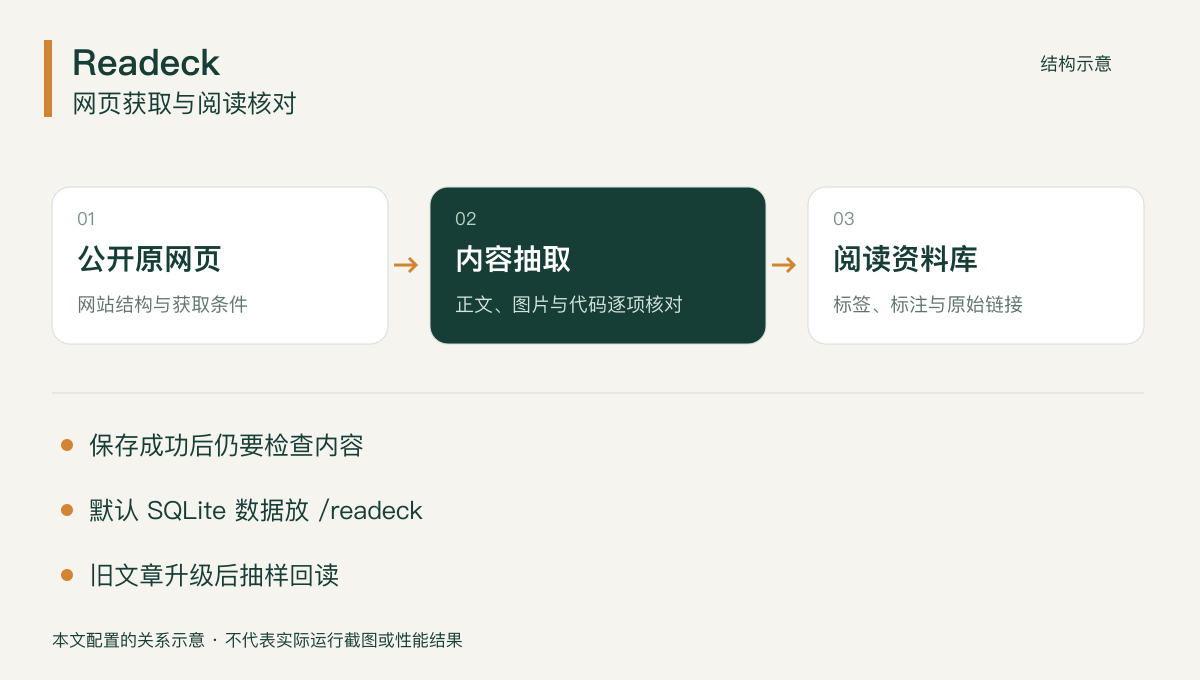
保存过程仍会受到网站结构影响。登录才能查看的资料、复杂脚本页面、视频和付费内容,不能假定都能得到完整离线副本。先用自己熟悉的几篇公开文章试验,比较原页与保存结果,再决定哪些资料可以依赖这个阅读库。
部署前先确认 VPS 的磁盘、内存和公网访问条件,也可以查看雨云云服务器;注册时填写优惠码 KuZhuJi。
一篇文章要核对的不只是标题
先保存一篇文字为主的文章、一篇带图片的教程,以及一篇包含代码块的文档。查看标题、正文开头与结尾、图片、链接和代码缩进,确认没有把导航当正文,也没有漏掉关键段落。文章保存成功与内容完整是两个不同的检查点。
做标注时保留足够上下文。只摘一句结论,几个月后可能忘记它的适用条件;记录日期、原页面地址以及自己为什么收藏,检索时更容易判断是否仍可使用。版本相关的技术教程尤其要记录所用软件版本,资料库不会自动把历史建议更新成当前做法。
标签按之后会怎样寻找来设计。例如“反向代理”“备份恢复”“需要验证”,而不是把站点名称、作者与所有关键词都塞进同一个标签体系。需要处理的阅读材料可以单独筛选,已经读过但仍有用的内容留作检索,不必因为读完就删除。
SQLite 部署先从一个容器开始
官方文档提供 Docker Compose 示例,当前镜像为 codeberg.org/readeck/readeck:latest,网页端口 8000,持久目录 /readeck。个人阅读库可以先使用默认 SQLite,避免为了第一次保存文章同时管理额外数据库。
VPS 需要 Docker Engine 与 Compose 插件,能拉取 Codeberg 镜像,有 SSH 权限和足够磁盘。内容图片与保存的文章会累积,不能只根据初始容器大小判断空间需求。本例使用宿主目录存数据,并将端口绑定到本机。
mkdir -p /opt/readeck
cd /opt/readeck
mkdir -p data
建立 compose.yaml:
services:
  readeck:
    image: codeberg.org/readeck/readeck:latest
    restart: unless-stopped
    ports:
      - "127.0.0.1:8000:8000"
    environment:
      READECK_LOG_LEVEL: "info"
      READECK_LOG_FORMAT: "text"
      READECK_SERVER_HOST: "0.0.0.0"
      READECK_SERVER_PORT: "8000"
    volumes:
      - ./data:/readeck
    security_opt:
      - no-new-privileges:true
    healthcheck:
      test: ["CMD", "/bin/readeck", "healthcheck", "-config", "config.toml"]
      interval: 30s
      timeout: 2s
      retries: 3
docker compose config --quiet
docker compose up -d
docker compose ps
docker compose logs --tail=100 readeck
在自己电脑上建立隧道,再进入 http://localhost:18000 完成首次设置:
ssh -N -L 18000:127.0.0.1:8000 user@VPS_IP
账号初始化完成后,保存三篇测试文章,重启容器并再次阅读,确认内容落在挂载目录。配置文件与密钥也会影响后续恢复,备份时不能只取一个数据库文件。健康检查失败时,先查看启动日志与目录权限,不要把它改成永远成功来消除红色状态。
准备独立实例时,可在雨云选择适合的云服务器配置,优惠码 KuZhuJi。配置按实际任务选择,数据库和附件另做备份。
让浏览器保存动作足够简单
长期使用时,给阅读库一个独立 HTTPS 子域名,用现有代理转发至 127.0.0.1:8000。代理在另一台机器或容器里时,必须使用实际可达的网络地址;它自己的 localhost 并不是本例的应用地址。
按官方浏览器扩展说明接入实例。先在桌面端保存一篇测试文章,再在手机上登录阅读,检查图片与标注。扩展密钥或应用密码属于凭据,失去设备控制后应在服务端撤销,不能只删除浏览器历史。
保存失败时,区分账号验证问题和目标网页获取问题。应用入口能打开,不代表 VPS 能访问目标网站;目标页面能在你的电脑打开,也不代表服务器收到同样内容。遇到需要登录或反爬验证的页面,保留原链接与必要备注,不要承诺后台一定可以抓取。
遇到坏的抽取结果,优先确认当前版本是否允许编辑或重新处理,再决定是否保留该副本。重要资料保留原始文件、作者提供的下载版或自己的合法备份,避免只存一个已经缺失关键内容的阅读页面。
需要增加服务器时,可以打开雨云选购页面,填写优惠码 KuZhuJi;迁移前保留数据与原有部署配置。
收藏量增长后先整理用途
大量导入浏览器书签时,记录“已保存链接”与“已取回内容”的差别,抽样看旧资料是否仍可抓取。几千个条目同时加入可能带来后台请求和磁盘增长,应分批导入,并观察日志与存储变化。本文没有测量抓取吞吐,不能给出固定分钟数或容量承诺。
需要共享给别人时,用无关敏感信息的样本确认分享范围,检查访问者是否能看到其他条目。不要从一个公开分享按钮推断整个账号资料都已隔离,也别把团队内部文档放入对外分享链接。
完整目录备份与导出用途不同
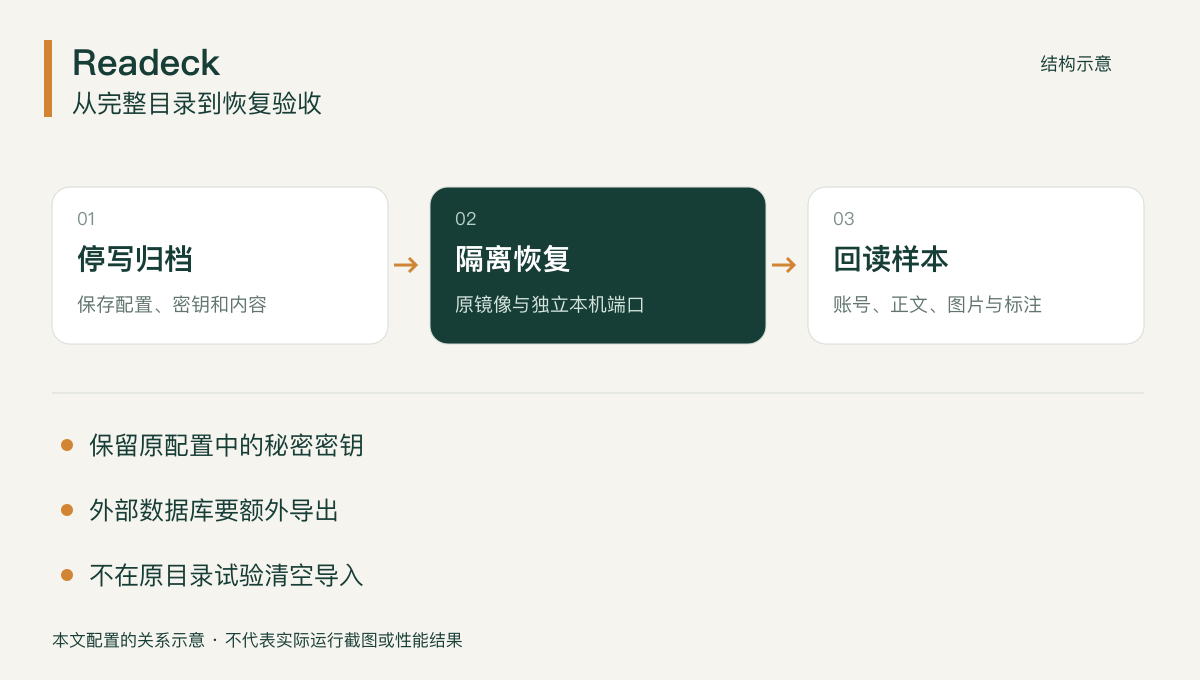
Readeck 提供数据导出与导入命令,适合用户迁移和跨实例处理,但导入选项会影响用户是否被跳过、唯一标识是否保留。现有实例恢复不能把“导入 ZIP”当成无条件覆盖,带清空选项的操作还会删除原实例用户与关联数据。
本例使用 SQLite,可以先停写并保留整个 /readeck 对应宿主目录与 Compose。这样无需在首次备份时猜配置、数据库和内容文件各在哪一处。备份应复制到另一台机器,并限制访问。
cd /opt/readeck
umask 077
mkdir -p backup-out
docker compose stop readeck
sudo tar -czf "backup-out/readeck-$(date +%F-%H%M%S).tgz" data compose.yaml
docker compose start readeck
恢复时在独立目录和不同端口启动原镜像版本,抽查原账号、正文、图片、标注与标签。若要延续原 API 令牌和应用密码,应保留原配置中的密钥,并按官方恢复方法检查标识。采用 PostgreSQL 的实例还必须额外保存数据库导出,不能沿用这里只归档一个目录的方案。
每次升级前保存可恢复副本,升级后抽查之前那三类文章。阅读库里的旧页面能否正常打开,比新版本首页的外观更能说明这次迁移是否完成。